Étude de cas
llmde
Extraction de données assistée par IA pour les revues systématiques, chaque valeur reliée à la page et à la citation dont elle provient.
Un pipeline d’extraction par modèle de langage pour une revue systématique et une méta-analyse, construit pour que chaque valeur porte sa page et sa citation et qu’une relectrice humaine garde le dernier mot.
L’outil
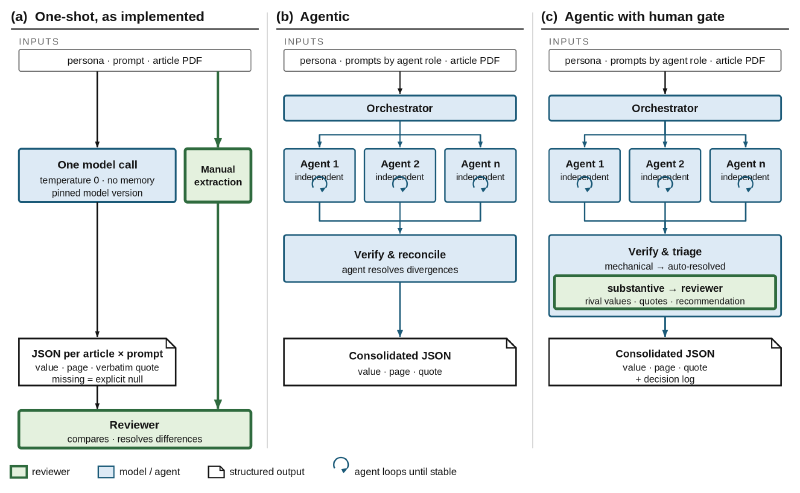
Extraire à la main les données de 39 essais est lent et varie d’une lectrice à l’autre. llmde confie la partie mécanique à un modèle de langage sous des règles strictes : extraire exactement sans interpréter, renvoyer un null explicite pour toute information absente, et citer la page et le passage derrière chaque valeur.
La construction des prompts
Chaque prompt a été rédigé, testé sur deux ou trois articles volontairement variés en parallèle d’une lecture humaine, puis révisé partout où les deux lectures divergeaient. Chaque écart a été diagnostiqué avant toute modification, la plupart venant d’une définition à double lecture ou d’une variante de rapport sans règle prévue.

Les livrables
- Extraction en double. 39 essais pour la revue et 19 pour la méta-analyse, une fois à la main et une fois par le modèle (Claude Opus 4.6), réconciliées par discussion, avec une précision de 97 % du modèle face à l’extraction manuelle.
- Paquet open source. llmde sur GitHub, licence MIT : cinq prompts d’extraction, une instruction système, des connecteurs Claude et Gemini, une interface en ligne de commande qui reprend les exécutions interrompues.
- Méthode documentée. Chapitre 5 de la thèse : la conception à appel unique à côté de deux variantes agentiques, avec un plaidoyer pour conserver un passage humain.
Mon rôle
J’ai dirigé le projet : j’ai conçu la méthode d’extraction et corédigé les prompts et les schémas, et Mathieu Scheltienne les a implémentés sous forme de paquet. J’ai assuré le volet modèle de l’extraction en double et l’ai réconcilié avec le volet manuel.
Compétences démontrées
- Des flux de travail LLM conçus avec la vérification intégrée : trace de preuve, nulls explicites, contrôles structurels, version de modèle figée.
- Une méthode de synthèse des preuves : extraction en double et calibration sur un échantillon pilote, comme le recommandent les guides de revue.
- La capacité à spécifier une méthode assez précisément pour qu’un ingénieur en fasse un outil réutilisable.